OCR par lots
La reconnaissance optique de caractères (OCR) consiste à utiliser des algorithmes informatiques pour extraire des informations textuelles à partir d'images. Si les outils OCR sont activés sur votre portail Symbiota, vous pouvez les utiliser pour tenter d'extraire des informations textuelles de photos (par exemple, des étiquettes de spécimens) et saisir directement les données dans les champs appropriés. Les instructions relatives à l'utilisation des processus OCR par lots sont fournies ci-dessous. Pour savoir comment utiliser l'OCR dans l'éditeur d'occurrences, consultez la page OCR du Guide de l'éditeur.
Génération OCR par lots pour les enregistrements d'un portail
Pour exécuter l'OCR sur plusieurs images de spécimens simultanément :
- Accédez à votre panneau de contrôle d'administration (cliquez sur « Mon profil », puis sur le nom de la collection dans le bloc « Gestion des collections »).
- Cliquez sur « Boîte à outils de traitement » (Processing Toolbox).
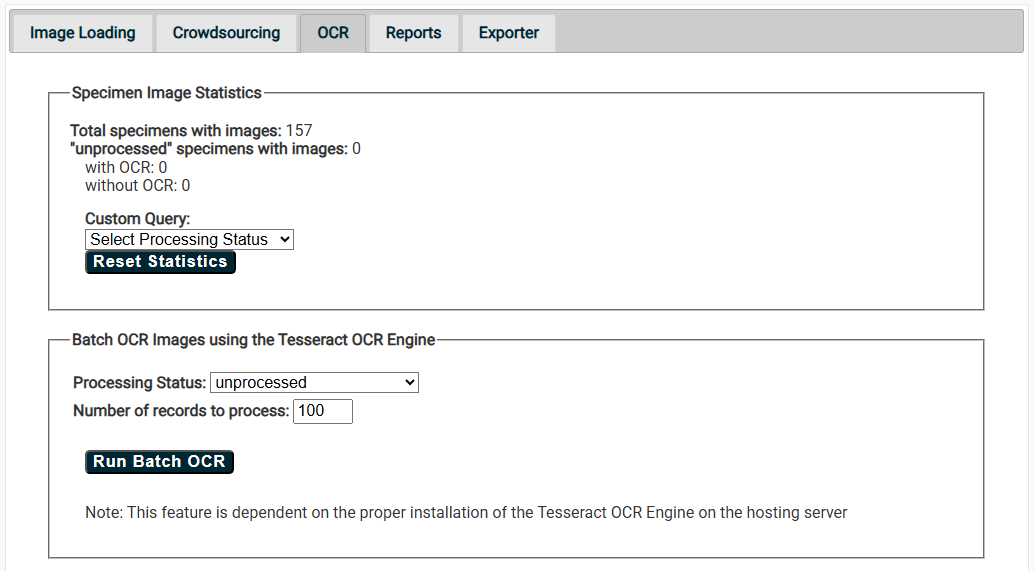
- Si l'OCR est activé sur votre portail, cliquez sur l'onglet « OCR ».
- À partir de là, vous pouvez voir combien de spécimens disposent d'un résultat OCR enregistré et lancer l'OCR sur un nombre défini de spécimens à l'aide du bloc Batch OCR Images using the Tesseract OCR Engine (Traitement OCR par lots des images via le moteur Tesseract). Indiquez le statut de traitement des enregistrements concernés dans le champ « processing status » (statut de traitement) et précisez le nombre d'enregistrements à traiter simultanément dans le champ « Number of records to process » (nombre d'enregistrements à traiter).
Une vidéo explicative de ce processus est disponible ici :
Importation de fichiers OCR pré-générés
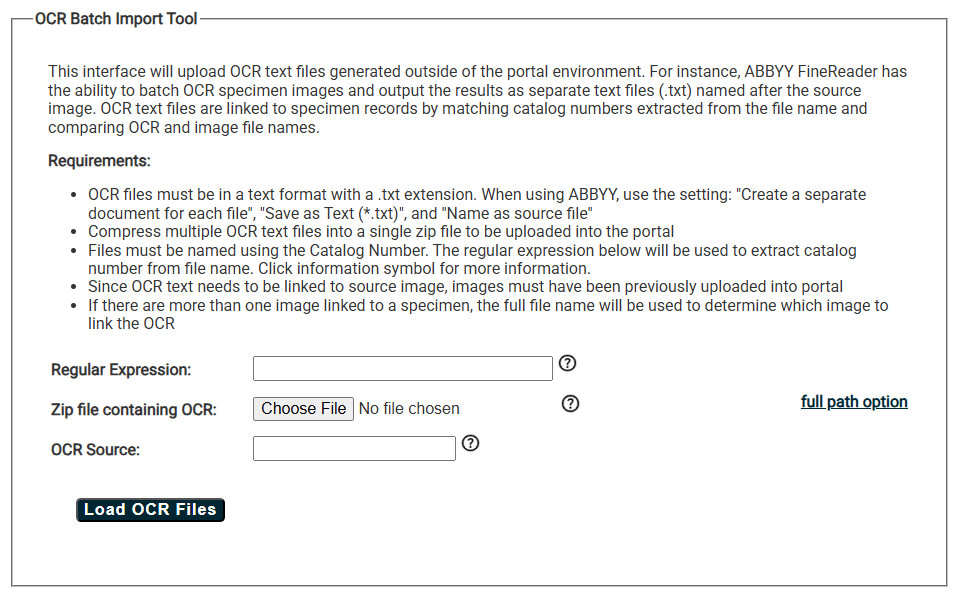
Certains portails disposent d'une interface permettant d'importer des fichiers texte OCR générés en dehors de l'environnement du portail. Par exemple, ABBYY FineReader permet de traiter par lots des images de spécimens via OCR et d'exporter les résultats sous forme de fichiers texte distincts (.txt) portant le nom de l'image source. Les fichiers texte OCR sont associés aux fiches des spécimens en faisant correspondre les numéros de catalogue extraits du nom de fichier et en comparant les noms des fichiers OCR et des fichiers image.
Cet outil est également accessible via l'onglet OCR de la boîte à outils de traitement (Processing Toolbox).
Pour importer un fichier, assurez-vous que votre collection et vos fichiers répondent aux exigences suivantes :
- Les fichiers OCR doivent être au format texte avec une extension .txt. Si vous utilisez ABBYY, sélectionnez les paramètres suivants : « Créer un document distinct pour chaque fichier », « Enregistrer au format texte (*.txt) » et « Utiliser le nom du fichier source ».
- Compressez plusieurs fichiers texte OCR dans une seule archive ZIP pour les importer dans le portail.
- Les fichiers doivent être nommés en utilisant le numéro de catalogue. L'expression régulière ci-dessous sera utilisée pour extraire le numéro de catalogue du nom de fichier.
- Comme le texte OCR doit être associé à l'image source, les images doivent avoir été préalablement importées dans le portail.
- Si plusieurs images sont associées à un spécimen, le nom complet du fichier sera utilisé pour déterminer à quelle image associer l'OCR.